
- Srovnali jsme výkon AI modelů na nejvýkonnějším MacBooku a nejvýkonnějším Macu Studio
- Oba stroje jsou extrémně výkonné, rozdíly jsou přesto jasně patrné
- MacBook logicky limituje i chlazení
Obsah článku
MacBook Pro vs. Mac Studio a AI výkon
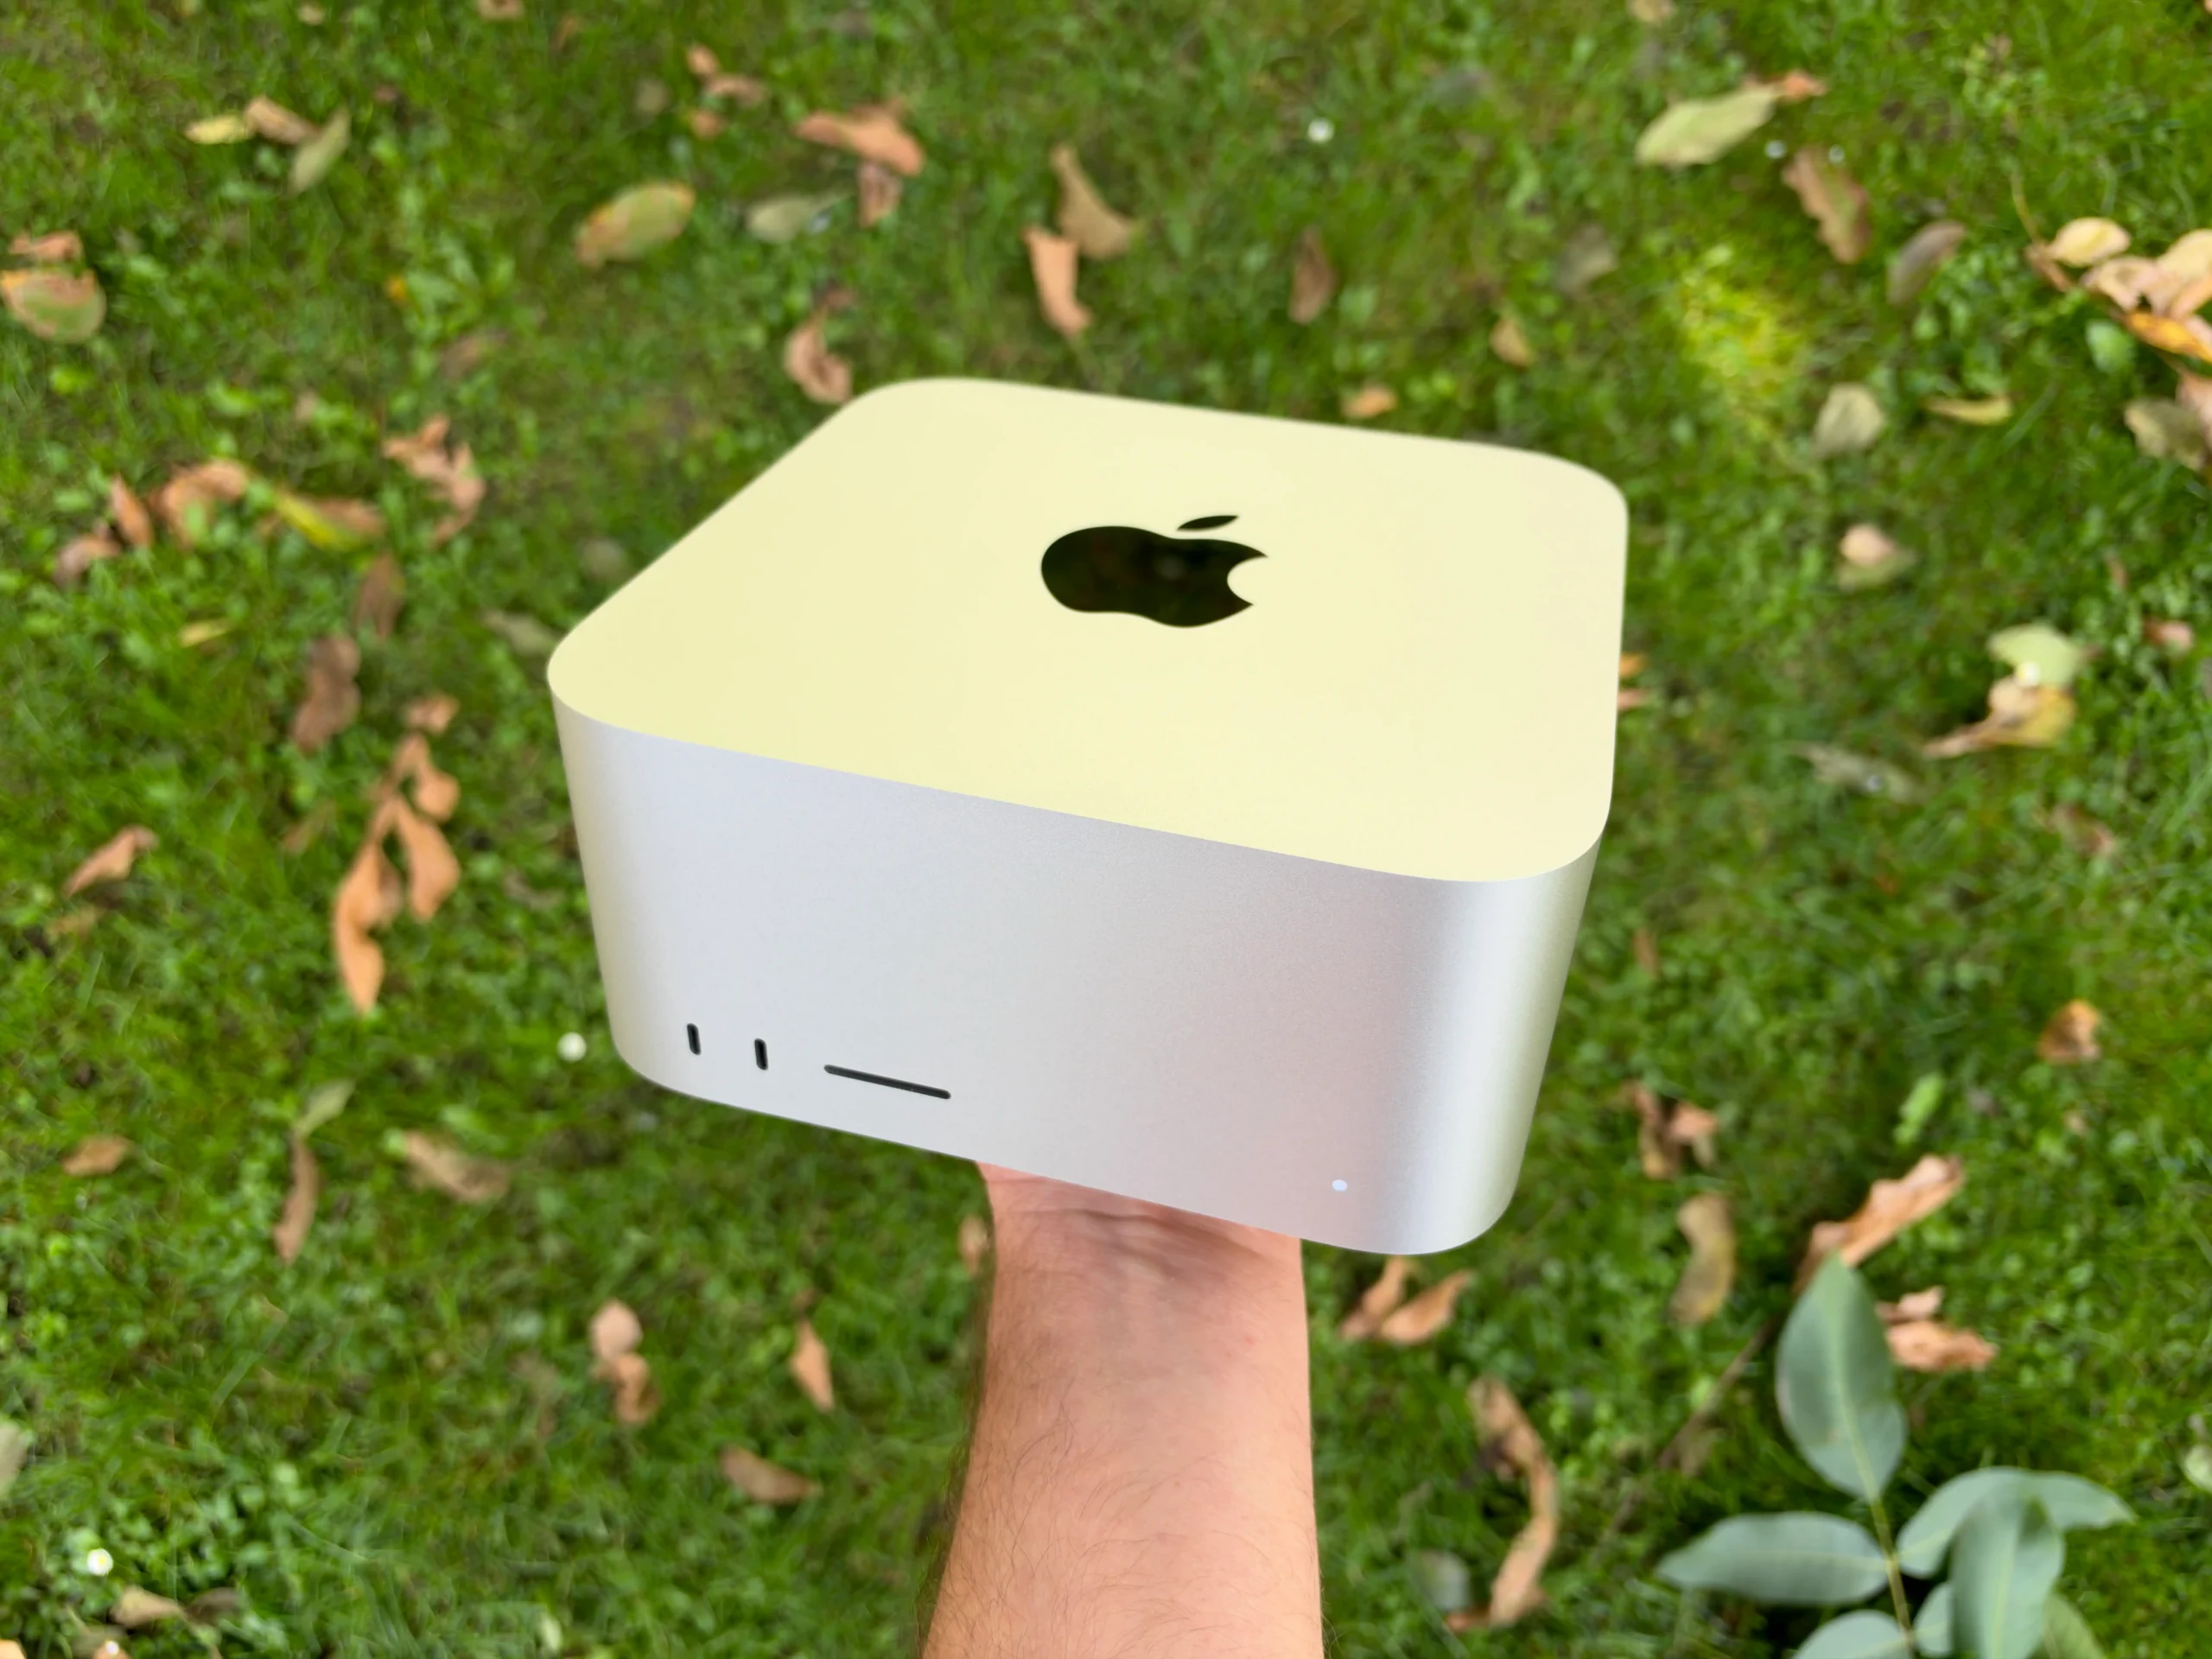
Počítače od Applu si dnes velká spousta uživatelů kupuje pro provoz lokálních AI modelů. M čipy jsou totiž extrémně efektivní a s AI výpočty si umějí poradit opravdu zdatně. Abychom si upřesnili podmínky měření, jednalo se o tyto dva stroje:
| Konfigurace | MacBook Pro M5 Max | Mac Studio M5 Ultra |
|---|---|---|
| Čip | Apple M5 Max | Apple M5 Ultra |
| CPU | 18 jader | 36 jader |
| GPU | 40 jader | 80 jader |
| RAM | 128 GB | 256 GB |
| Úložiště | 4 TB SSD | 4 TB SSD |
Test proběhl ve stejné místnosti, ve stejný čas (přibližně). Jak Studio, tak i MacBook byly dost slyšet, ale Mac Studio přeci jenom hlučel méně, protože má logicky mohutnější chladicí soustavu a je na dlouhodobou zátěž stavěný. Co je podstatné – v obou případech se jedná o nejvýkonnější možnou konfiguraci. Další příplatky jsou možné akorát u úložného prostoru, což na AI výkon nemá vliv a víc jak 4 TB asi využije opravdu málokdo.
Testovací metodika
Test lokálních AI modelů jsme navrhli tak, aby byly výsledky MacBooku Pro M5 Max a Macu Studio M5 Ultra přímo srovnatelné. Na obou počítačích proto běžela stejná sada 32 lokálních jazykových modelů, stejné varianty jednotlivých modelů a stejné nastavení testu. Modely jsme provozovali lokálně prostřednictvím Ollamy, takže veškerá inference probíhala přímo na testovaném počítači. Nebyl využíván žádný cloudový výpočet ani vzdálený server.
Samotné měření výkonu AI modelů obsluhoval připravený Python skript. Díky tomu nebylo nutné jednotlivé modely spouštět ručně a všechny dostaly stejné podmínky. Skript model načetl do paměti, provedl zahřívací fázi a následně spouštěl jednotlivá měření. Po dokončení testu jednoho modelu byl model z paměti uvolněn a před pokračováním následovala 30sekundová pauza. Pořadí modelů bylo navíc promícháno, aby výsledky co nejméně ovlivňovalo například postupné zahřívání počítače během několikahodinového testu.
Všechny modely dostaly přesně stejné zadání: „Napiš velmi dlouhý odborný technický text o konstrukci moderního automobilu. Piš souvisle, věcně a technicky přesně. Pokračuj v psaní až do dosažení maximální povolené délky výstupu. Nevkládej závěr předčasně.“ Nešlo nám přitom o hodnocení kvality vytvořeného textu. Zadání sloužilo především jako dostatečně dlouhá a pro všechny modely stejná úloha, na které bylo možné změřit rychlost generování.
Maximální délku jednoho výstupu jsme nastavili na 2 000 tokenů. Kontextové okno mělo velikost 8 192 tokenů a teplota byla nastavena na 0, aby se co nejvíce omezila náhodnost mezi jednotlivými běhy. V testovacím skriptu jsme používali také stejný seed a u modelů jsme vypnuli samostatný režim přemýšlení, aby některé modely nevynakládaly část výkonu na dodatečný reasoning, který by ostatní modely nepoužívaly.
Každý ze 32 modelů prošel celkem jedenácti samostatnými měřeními. První běh jsme z výsledků záměrně vyřadili, protože jeho chování může být ovlivněno prvotním načtením modelu, alokací paměti nebo dalšími jednorázovými operacemi. Výsledná hodnota uvedená v tabulkách proto představuje aritmetický průměr rychlosti z běhů 2 až 11. Pro každý model tak máme deset započítaných měření namísto jediné hodnoty, která by mohla být ovlivněna krátkodobým výkyvem výkonu.
Hlavní sledovanou veličinou byla rychlost generování udávaná v tokenech za sekundu, tedy tok/s. Počet tokenů modelu jsme vydělili čistou dobou generování odpovědi. Nejde tedy o celkový čas od odeslání požadavku do zobrazení odpovědi, ale o samotnou rychlost inference. Vyšší hodnota znamená, že model na daném hardwaru dokázal vytvářet více tokenů za sekundu. Výsledek ale nic neříká o inteligenci modelu, přesnosti jeho odpovědí nebo kvalitě vytvořeného textu. Jde čistě o benchmark výkonu hardwaru při lokálním provozu jazykových modelů.
Výsledky AI testu: MacBook Pro vs. Mac Studio
| MacBook Pro M5 Max | Model | Mac Studio M5 Ultra |
|---|---|---|
| qwen3:4bStudio +67,5 % | ||
| qwen3:30bStudio +51,0 % | ||
| gpt-oss:20bStudio +67,8 % | ||
| qwen2.5:7bStudio +89,5 % | ||
| qwen3.5:35b-mlxStudio +16,7 % | ||
| qwen3.5:9bStudio +86,0 % | ||
| gpt-oss:120bStudio +57,5 % | ||
| gemma4:26bStudio +64,2 % | ||
| qwen3-coder-next:latestStudio +44,2 % | ||
| qwen3-next:80bStudio +29,2 % | ||
| gemma4:26b-mlx-bf16Studio +58,6 % | ||
| gemma4:e4bMacBook +0,2 % | ||
| qwen3.8:27b-mlxStudio +139,2 % | ||
| gemma4:12bStudio +94,1 % | ||
| ministral-3:14bStudio +98,7 % | ||
| gemma3:12bStudio +87,8 % | ||
| qwen3.5:122b-a10bStudio +80,8 % | ||
| phi4-reasoning:plusStudio +106,6 % | ||
| llama4:scoutStudio +85,4 % | ||
| mistral-small3.2:24bStudio +135,4 % | ||
| qwen3.8-flash-next:125b-mlxStudio +20,6 % | ||
| gemma4:12b-mlx-bf16Studio +76,3 % | ||
| qwen3.5:27bStudio +120,0 % | ||
| gemma3:27bStudio +123,9 % | ||
| qwen3:32bStudio +131,5 % | ||
| gemma4:31bStudio +112,3 % | ||
| qwen3.8:27b-mlx-bf16Studio +102,9 % | ||
| gemma4:31b-mlx-bf16Studio +101,8 % | ||
| deepseek-r1:70bStudio +156,8 % | ||
| llama3.3:70bStudio +152,7 % | ||
| command-a:111bStudio +175,6 % | ||
| mistral-large:123bStudio +163,3 % |
Výsledky ukazují poměrně jasně, že Mac Studio M5 Ultra má při lokálním provozu jazykových modelů proti MacBooku Pro M5 Max výraznou výhodu. U 31 z 32 testovaných modelů byl rychlejší a medián nárůstu výkonu vyšel přibližně na 89 %. U některých modelů byl rozdíl ještě podstatně větší. Command A 111B zrychlil z 5,58 na 15,38 tok/s, Mistral Large 123B z 5,20 na 13,69 tok/s a DeepSeek R1 70B z 8,82 na 22,65 tok/s. Právě u velkých a náročných modelů je tedy náskok Macu Studio nejvýraznější. Jedinou výjimkou byla Gemma 4 E4B, která na obou počítačích dosáhla prakticky stejného výsledku.
Zajímavé zároveň je, že dvojnásobný počet GPU jader a dvojnásobná kapacita RAM automaticky neznamenají dvojnásobný výkon u každého modelu. Rozdíly se podle architektury a konkrétní varianty modelu výrazně mění. Například Qwen 3.5 35B MLX zrychlil jen o necelých 17 %, zatímco Qwen 3.8 27B MLX o 139 %. Test tak dobře ukazuje, že u lokální AI nezáleží pouze na hrubém výkonu počítače, ale také na tom, jak dobře dokáže konkrétní model dostupný hardware využít. Pokud ale jde o provoz velkých modelů, Mac Studio M5 Ultra už nabízí výkon, při kterém se i modely se 70 nebo více než 100 miliardami parametrů dostávají na rychlosti použitelné pro běžnou práci.
Co si z toho odnést?
Test jsme dělali z jednoduchého důvodu. Existují lidé, kteří váhají mezi MacBookem a stolním Macem a v případě takto výkonných konfigurací jsou to často jedinci, kteří pracují s lokálními AI modely. Těm může test pomoci v rozhodování mezi oběma stroji.
Zdroj: autorský text, tomshardware
Obrázky: Ludvík Eckerman, vygenerováno Midjourney