
- Vyzkoušeli jsme Mac Studio v testu s velkým lokálním modelem
- Qwen3 235B, zabral 133 GB paměti a psal 46 tokenů za sekundu
- Grafika se zahřála nejvýš na 87 °C, ani po deseti minutách plné zátěže Mac nezpomalil
Obsah článku
Mac Studio a velké AI modely
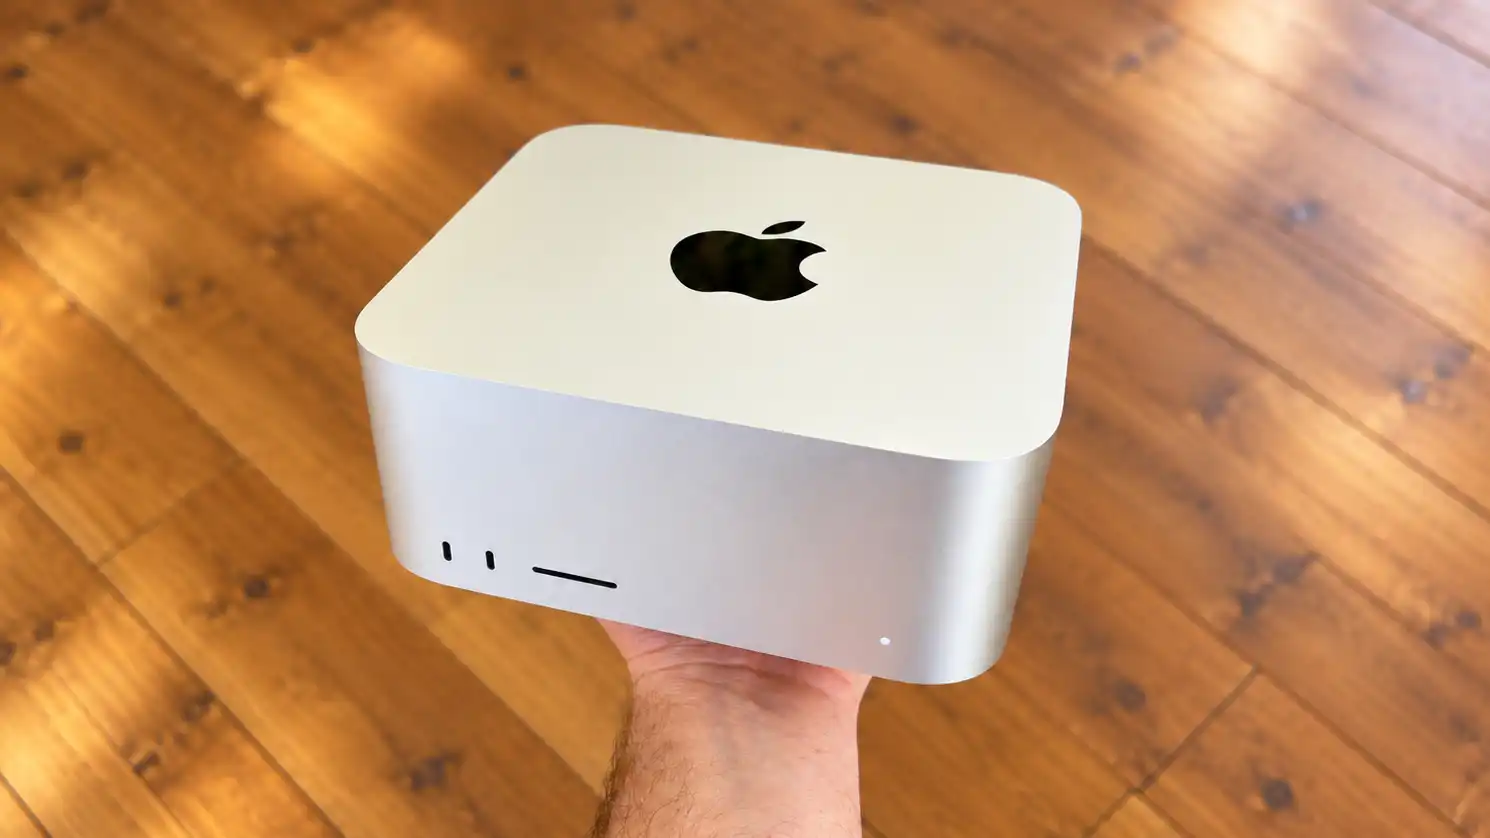
Na Macu Studio s čipem M5 Ultra a 256 GB paměti jsme spustili pět modelů od 8 do 235 miliard parametrů, a to ve dvou nejběžnějších programech pro lokální AI. Největší z nich, Qwen3 235B, si vzal 133 GB paměti a psal 46 tokenů za sekundu. Navazujeme na náš hodinový zátěžový test, ve kterém jsme sledovali hlavně rychlost generování a spotřebu elektřiny. Tentokrát nás zajímalo i to, co se v Macu děje ještě před první vygenerovanou větou.
Jak jsme měřili
Testovali jsme Mac Studio s čipem M5 Ultra, 80jádrovou grafikou, 256 GB sjednocené paměti a macOS 27.0.1. Kromě testu na něm nic jiného neběželo. Modely jsme spouštěli ve dvou programech. Prvním je llama.cpp, populární nástroj, na kterém stojí řada aplikací pro lokální AI. Druhým je MLX, knihovna přímo od Applu napsaná pro čipy Apple Silicon (MLX 0.32 s nadstavbou mlx-lm). V llama.cpp běžely všechny vrstvy modelu na grafice.
Vyzkoušeli jsme pět modelů: Qwen3 8B, Qwen3 30B-A3B, Llama 3.3 70B, gpt-oss-120b a Qwen3 235B-A22B. Všechny běžely ve 4bitové kvantizaci, tedy ve zmenšené verzi, která zabere zhruba čtvrtinu paměti oproti plné přesnosti. gpt-oss byl ve formátu MXFP4. Qwen3 235B jsme měřili jen v MLX. Každý model nejdřív dostal prompt o 512 a 4 096 tokenech a pak měl vygenerovat 128 tokenů. Potom totéž s promptem o 16 384 tokenech. Na závěr jsme Mac deset minut bez přestávky zatížili modelem Qwen3 30B-A3B. Teploty, otáčky ventilátoru, frekvenci grafiky a příkon čipu zapisoval nástroj macmon.
Výsledky
Tabulka ukazuje dvě různé rychlosti. Generování říká, jak rychle model píše odpověď. Načtení promptu je rychlost, jakou model přečte vaše zadání. Obojí v tokenech za sekundu, přičemž token je zhruba kus slova.
| Model | Paměť | Generování | Načtení promptu 4k | ||
|---|---|---|---|---|---|
| llama.cpp | MLX | llama.cpp | MLX | ||
| Qwen3 8B | ≈ 5 GB | 149 | 176 | 4 205 | 6 360 |
| Qwen3 30B-A3B | ≈ 18 GB | 172 | 159 | 4 535 | 9 870 |
| Llama 3.3 70B | ≈ 42 GB | 23 | 25 | 509 | 716 |
| gpt-oss-120b | ≈ 63 GB | 142 | 130 | 3 387 | 6 538 |
| Qwen3 235B-A22B | ≈ 133 GB | – | 46 | – | 1 656 |
Tokeny za sekundu s prázdným kontextem: vygenerování 128 tokenů a načtení promptu o 4 096 tokenech. Tučně rychlejší z obou programů. Qwen3 235B jen v MLX. Měřeno 24. 10. 2026.
Dlouhý dokument Mac Studio přečte za pár sekund
Než model napíše první slovo, musí přečíst celé zadání. Pokud mu dáte ke shrnutí dlouhý dokument, právě tahle fáze rozhoduje o tom, jak dlouho budete na odpověď čekat. Mac Studio ji zvládá rychle. gpt-oss-120b v MLX čte 6 538 tokenů za sekundu, dokument o 4 000 tokenech tak má přečtený za necelou sekundu. Qwen3 235B na to potřebuje asi dvě a půl sekundy.
Nejpomalejší je Llama 3.3 70B se 716 tokeny za sekundu, se stejným dokumentem se zdrží zhruba šest sekund. Jde o takzvaný hustý model, který na každý token používá všech 70 miliard parametrů. Proto zaostává i za modely, které jsou na papíře mnohem větší.
llama.cpp, nebo MLX?
Při čtení promptu vyhrálo MLX u všech modelů, a to 1,4× až 2,2×. Nejvýrazněji u Qwen3 30B-A3B, kde rychlost vyskočila ze 4 535 na 9 870 tokenů za sekundu. Applu se tedy vyplatilo napsat si vlastní knihovnu na míru svým čipům. Mac Studio z toho těží opravdu brutálně.
U generování už tak jasný vítěz není. MLX bylo o něco rychlejší u Qwen3 8B a Llamy 3.3 70B, llama.cpp naopak u Qwen3 30B-A3B a gpt-oss-120b. Rozdíly jsou navíc malé, v řádu jednotek až nižších desítek tokenů za sekundu. Kdo to s lokální AI na Macu myslí vážně, měl by si s vlastním modelem vyzkoušet obojí.
Co udělá dlouhý kontext
A co když model dostane opravdu dlouhé zadání? S promptem o 16 384 tokenech se generování v MLX zpomalilo o 12 až 31 procent. Nejlépe si vedly gpt-oss-120b a Llama 3.3 70B, které ztratily asi 12 procent. Modely Qwen zpomalily skoro o třetinu.
| Model | Generování | Změna | Načtení promptu | Změna |
|---|---|---|---|---|
| Qwen3 8B | 121 | −31 % | 5 240 | −18 % |
| Qwen3 30B-A3B | 115 | −28 % | 6 822 | −31 % |
| Llama 3.3 70B | 22 | −12 % | 650 | −9 % |
| gpt-oss-120b | 114 | −12 % | 6 332 | −3 % |
| Qwen3 235B-A22B | 33 | −28 % | 1 289 | −22 % |
MLX, prompt o 16 384 tokenech a po něm 128 vygenerovaných tokenů, tokeny za sekundu. Změna generování proti prázdnému kontextu, změna načtení proti promptu o 4 096 tokenech.
Klesla i rychlost čtení, ale velmi různě. gpt-oss-120b přišel jen o 3 procenta, Qwen3 30B-A3B o 31 procent. I tak ale čte přes 6 800 tokenů za sekundu, takže v praxi pořád patří k nejrychlejším.
Qwen3 235B se do 128 GB nevejde
Největší model v testu zabral 133 GB paměti. Na Mac se 128 GB by se tedy nevešel a právě tady dává 256GB konfigurace smysl. Přesto psal 46 tokenů za sekundu, což je rychleji, než stihnete číst. Tajemství je v konstrukci. Qwen3 235B je model typu MoE (mixture of experts). Má sice 235 miliard parametrů, na každý token ale používá jen asi 22 miliard. Proto je skoro dvakrát rychlejší než výrazně menší, ale hustá Llama 3.3 70B.
Teploty a příkon
Nejvíc se grafika zahřála na 87 °C, a to při čtení dlouhých promptů s Llamou 3.3 70B a Qwen3 235B. Ventilátor se roztočil z 1 000 na 2 265 otáček za minutu, tedy na 62 procent svého maxima. Samotný čip si v nejnáročnější chvíli vzal 215 W. To je výrazně víc než 73 W z hodinového testu. Čtení promptu je ale jiná práce než generování. Model zpracovává tisíce tokenů naráz a grafika konečně počítá naplno, místo aby většinu času čekala na data z paměti.
Při deseti minutách nepřetržité zátěže držel Mac Studio na grafice frekvenci 1 606 MHz a Qwen3 30B-A3B celou dobu generoval 172 tokenů za sekundu. macOS hlásil normální tepelný stav a žádné zpomalení kvůli teplotě jsme nezaznamenali.
Oproti M3 Ultra
Pro hrubé srovnání s předchozí generací jsme pustili i standardní test llama.cpp s malým modelem Llama 2 7B (Q4_0). Výsledky M3 Ultra se stejným počtem grafických jader jsme převzali z komunitní tabulky llama.cpp.
| Čip | Načtení promptu | Generování |
|---|---|---|
| Mac Studio M3 Ultra (komunitní data) | ≈ 1 471 | ≈ 92 |
| Mac Studio M5 Ultra | 5 125 | 181 |
| Zrychlení | 3,5× | 2× |
llama.cpp, Llama 2 7B Q4_0, tokeny za sekundu. Údaje pro M3 Ultra vznikly na starších verzích llama.cpp.
Mac Studio M5 Ultra tedy čte prompty zhruba třiapůlkrát rychleji a generuje asi dvakrát rychleji. Berte to ale s rezervou. Komunitní čísla vznikla se staršími verzemi llama.cpp a část zrychlení může jít i na vrub novějšího softwaru.
Co test neukazuje
- Kvalitu odpovědí. Měřili jsme jen rychlost, ne to, jak chytře modely odpovídají.
- Jiné kvantizace. Všechny modely běžely ve 4bitové verzi. S vyšší přesností zaberou víc paměti a budou pomalejší.
- Dávkové zpracování. Každý test obsluhoval jediný dotaz. Server, který vyřizuje víc uživatelů najednou, by z Macu dostal víc tokenů za sekundu.
- Příkon celého počítače. 215 W je příkon čipu. Ventilátory, disk a ztráty ve zdroji v něm nejsou. Mac Studio však nebude mít hodnotu příkonu celkového nijak dramaticky vyšší.
- Přímé srovnání s naším testem 32 modelů. Ten běžel s jinými verzemi modelů a jiným nastavením, čísla proto nejsou přímo porovnatelná.
Zdroj: vlastní měření, llama.cpp
Obrázky. Ludvík Eckerman