
- Na nejvýkonnějším Macu Studio jsme zopakovali náš test lokálních AI modelů
- Vyzkoušeli jsme stejných 32 modelů a použili úplně stejnou metodiku jako na MacBooku Pro M5 Max
Obsah článku
Mac Studio M5 Ultra je pořádná AI workstation
Před časem jsme vzali MacBook Pro s čipem M5 Max a 128 GB jednotné paměti a vyzkoušeli na něm 32 lokálních jazykových modelů. Teď jsme dostali možnost stejný test zopakovat na výrazně výkonnějším Macu Studio. Aby měly výsledky smysl, nezměnili jsme na metodice prakticky nic. Stejné modely, stejné zadání, stejný počet opakování i stejná délka generovaného výstupu.
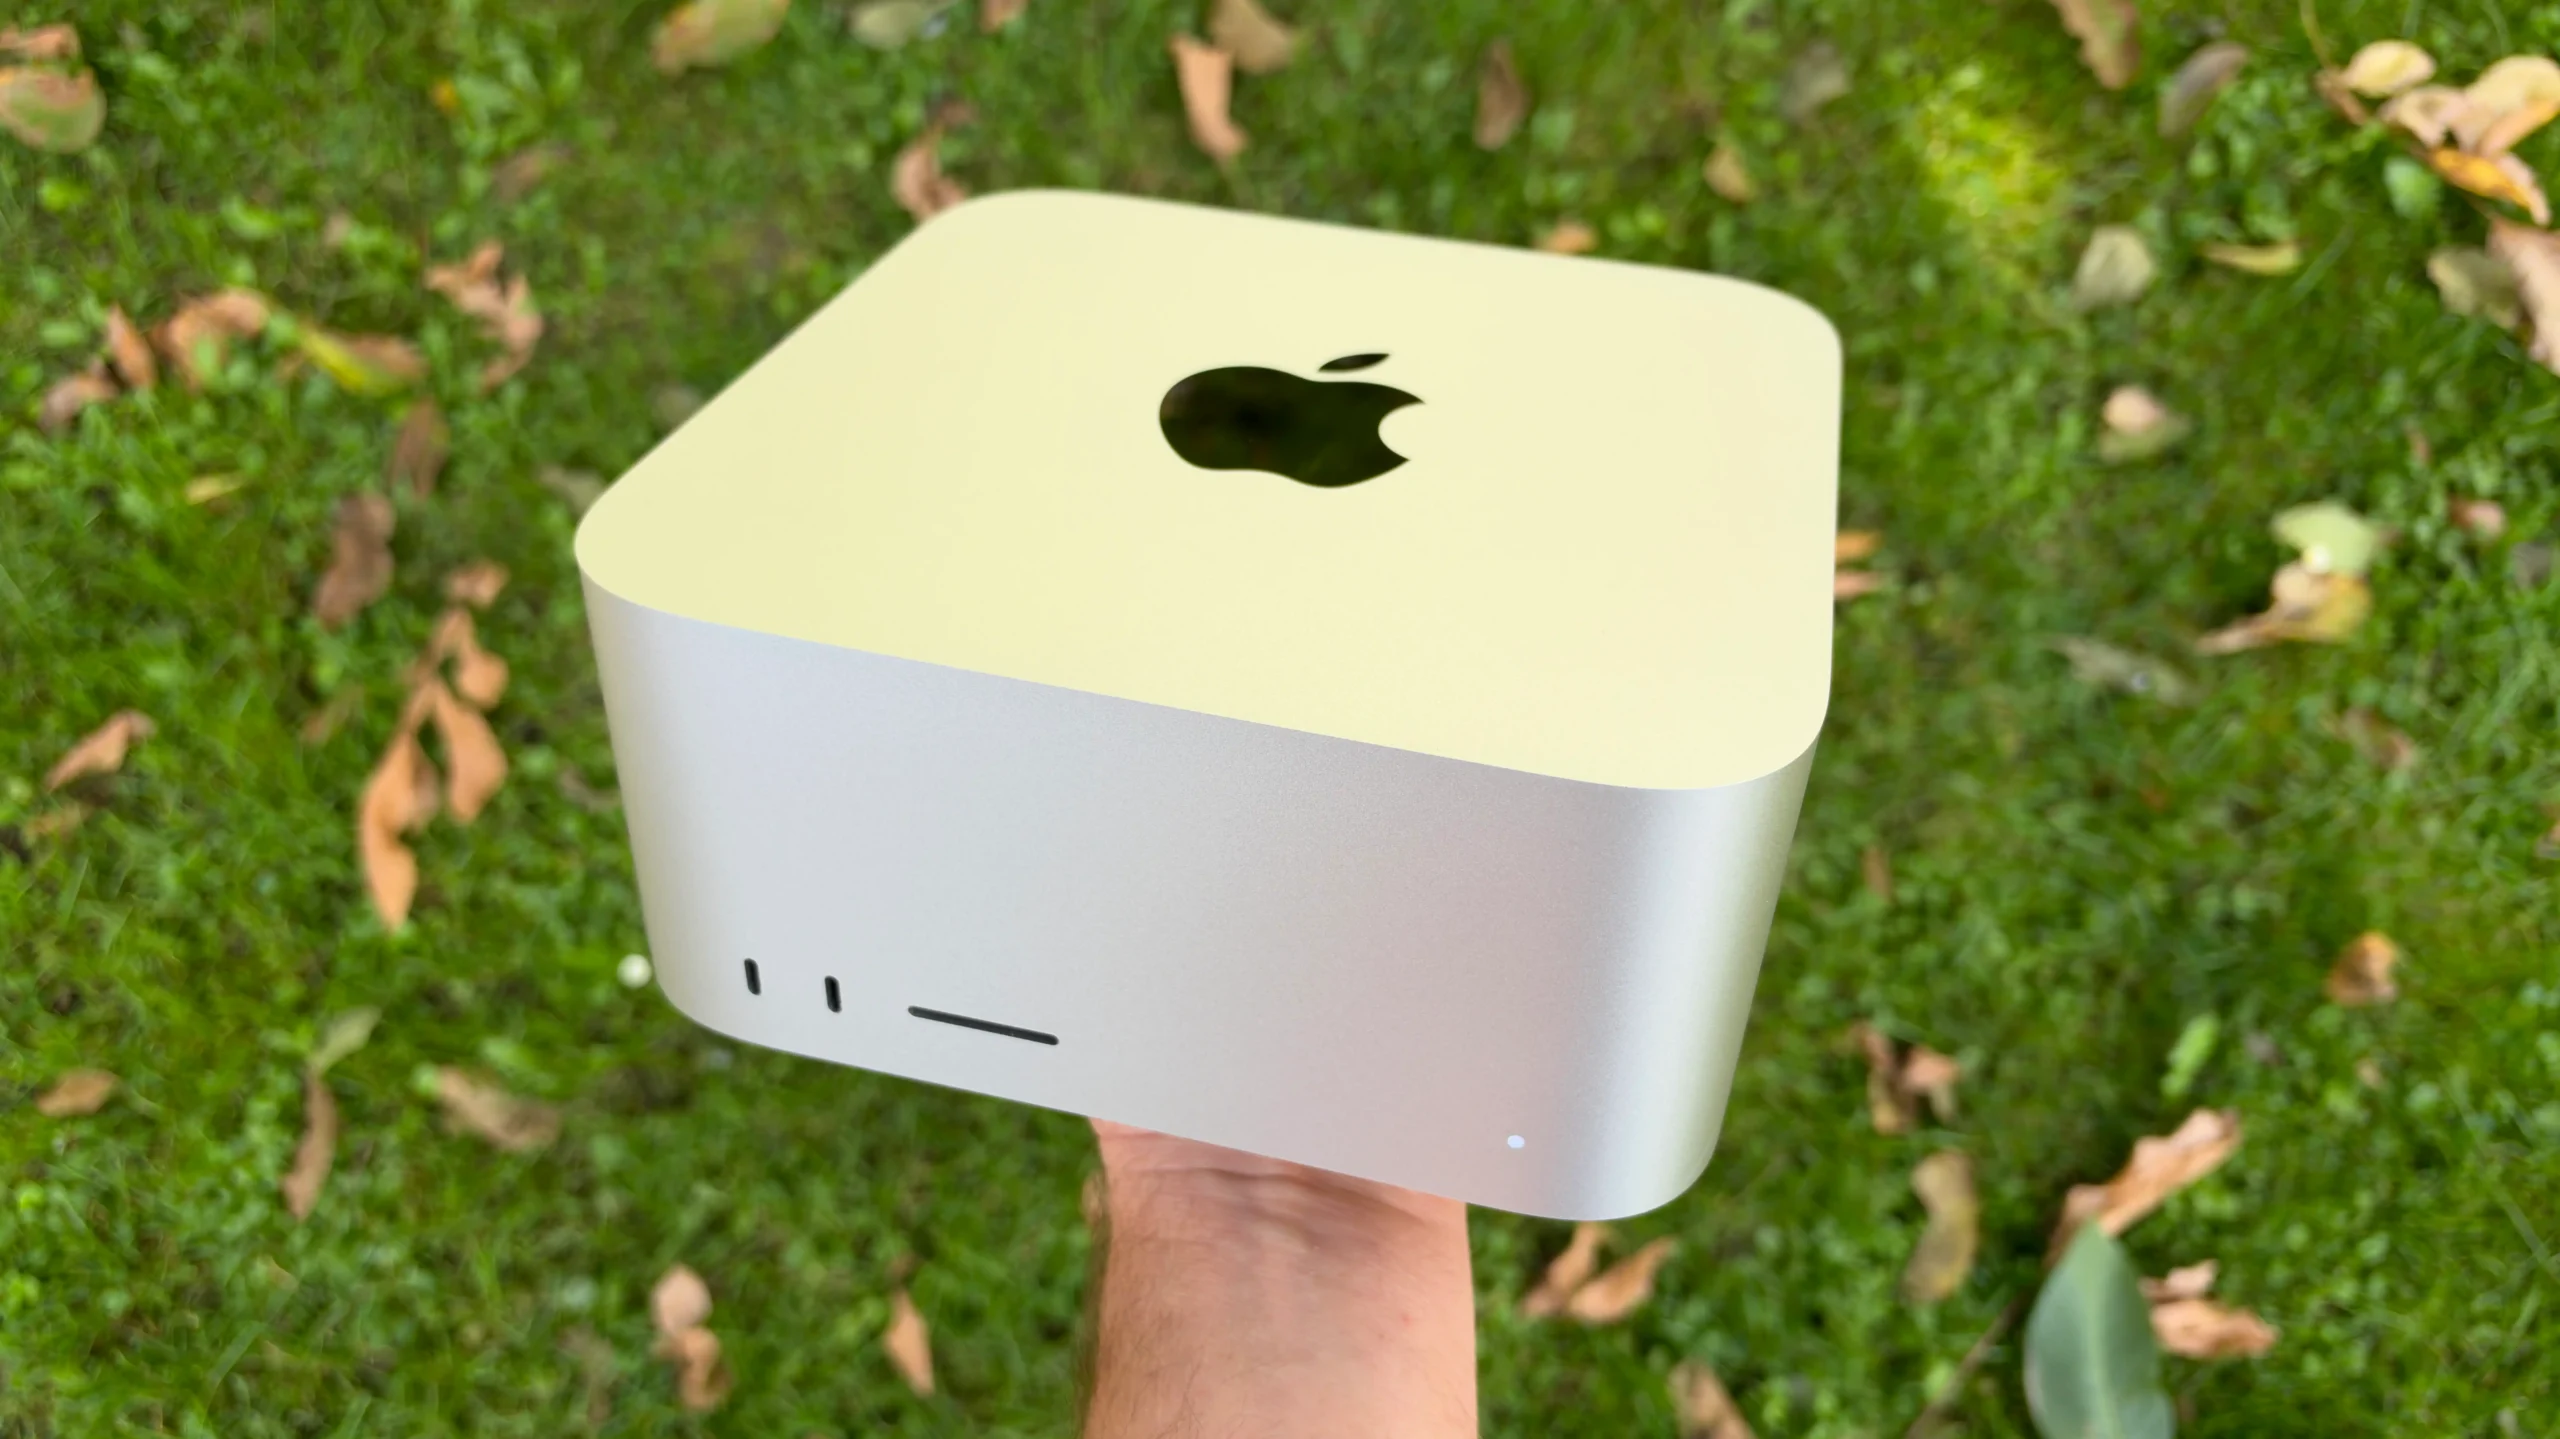
Testovaný Mac Studio je už konfigurací výrazně blíž pracovní stanici než běžnému domácímu počítači. Uvnitř je čip Apple M5 Ultra s 36jádrovým CPU a 80jádrovým GPU. K dispozici má 256 GB jednotné paměti s propustností 1,2 TB/s a 4TB SSD.
- Čip Apple M5 Ultra
- 36jádrové CPU
- 80jádrové GPU
- 256 GB jednotné paměti
- Propustnost paměti 1,2 TB/s
- 4TB SSD
Právě kombinace vysoké propustnosti a velké jednotné paměti je pro lokální AI velmi zajímavá. Model nemusí být rozdělený mezi klasickou RAM a samostatnou paměť grafické karty, protože CPU i GPU pracují se stejným paměťovým prostorem. Do 256 GB se navíc vejdou i modely, které jsou pro běžné počítače už hodně daleko za hranicí použitelnosti.
Srovnání 32 lokálních AI modelů na Mac Studio M5 Ultra
Níže jsou kompletní naměřené výsledky. Modely jsme stejně jako u předchozího testu seřadili od nejrychlejšího po nejpomalejší. Sledujeme čistě rychlost generování textu, nikoliv jeho kvalitu. Vyšší počet tokenů za sekundu tedy znamená pouze to, že daný model na testovaném hardwaru rychleji vytváří výstup.
| Model | Průměrný výkon |
|---|---|
| qwen3:4b | 203,31 tok/s |
| qwen3:30b | 170,12 tok/s |
| gpt-oss:20b | 169,35 tok/s |
| qwen2.5:7b | 154,19 tok/s |
| qwen3.5:35b-mlx | 144,87 tok/s |
| qwen3.5:9b | 126,59 tok/s |
| gpt-oss:120b | 115,21 tok/s |
| gemma4:26b | 111,74 tok/s |
| qwen3-coder-next:latest | 109,48 tok/s |
| qwen3-next:80b | 94,48 tok/s |
| gemma4:26b-mlx-bf16 | 93,21 tok/s |
| gemma4:e4b | 92,95 tok/s |
| qwen3.8:27b-mlx | 90,65 tok/s |
| gemma4:12b | 90,48 tok/s |
| ministral-3:14b | 88,66 tok/s |
| gemma3:12b | 88,26 tok/s |
| qwen3.5:122b-a10b | 84,80 tok/s |
| phi4-reasoning:plus | 76,10 tok/s |
| llama4:scout | 63,26 tok/s |
| mistral-small3.2:24b | 62,19 tok/s |
| qwen3.8-flash-next:125b-mlx | 54,60 tok/s |
| gemma4:12b-mlx-bf16 | 48,84 tok/s |
| qwen3.5:27b | 48,36 tok/s |
| gemma3:27b | 47,74 tok/s |
| qwen3:32b | 42,88 tok/s |
| gemma4:31b | 39,75 tok/s |
| qwen3.8:27b-mlx-bf16 | 36,65 tok/s |
| gemma4:31b-mlx-bf16 | 26,11 tok/s |
| deepseek-r1:70b | 22,65 tok/s |
| llama3.3:70b | 22,57 tok/s |
| command-a:111b | 15,38 tok/s |
| mistral-large:123b | 13,69 tok/s |
Rozpětí je i tentokrát obrovské. Nejrychlejší Qwen3 4B dosáhl v průměru 203,31 tokenu za sekundu, zatímco Mistral Large 123B skončil na 13,69 tok/s. Rozdíl mezi nejrychlejším a nejpomalejším modelem je tedy téměř patnáctinásobný. Medián všech 32 výsledků vyšel na 86,53 tok/s a hranici 100 tok/s překonalo devět modelů.
Znovu se také potvrzuje, že samotný počet parametrů nám o rychlosti modelu řekne poměrně málo. Dobře je to vidět například na GPT-OSS 120B, který se dostal na 115,21 tok/s, zatímco některé výrazně menší modely pracují několikanásobně pomaleji. Rozhoduje totiž nejen velikost, ale také architektura, použitá kvantizace, počet skutečně aktivních parametrů nebo optimalizace konkrétního formátu pro daný hardware.
Velmi zajímavě dopadl také Qwen 3.5 122B A10B. Přestože jde podle celkového počtu parametrů o jeden z největších modelů v našem testu, na Mac Studio generoval v průměru 84,80 tok/s. Označení A10B napovídá, že jde o Mixture of Experts model, který při vytvoření tokenu neaktivuje všech více než 120 miliard parametrů současně.
Mac Studio a lokální AI modely: jak jsme testovali
Stejně jako minule probíhal celý test prostřednictvím Ollamy. Jde o nástroj pro lokální provoz jazykových modelů, který model stáhne, načte do paměti a následně zajišťuje samotnou inferenci. Výpočty tedy neběžely v cloudu ani na vzdálených serverech, ale přímo na testovaném Macu Studio.
Modely, které jsme testovali
- Qwen: qwen3.5:35b-mlx, qwen3:4b, qwen3:30b, qwen2.5:7b, qwen3-coder-next, qwen3-next:80b, qwen3.5:9b, qwen3.5:122b-a10b, qwen3.8-flash-next:125b-mlx, qwen3.8:27b-mlx, qwen3.5:27b, qwen3:32b, qwen3.8:27b-mlx-bf16
- Gemma: gemma4:e4b, gemma4:26b, gemma4:26b-mlx-bf16, gemma3:12b, gemma4:12b, gemma4:12b-mlx-bf16, gemma3:27b, gemma4:31b, gemma4:31b-mlx-bf16
- GPT-OSS: gpt-oss:20b, gpt-oss:120b
- Meta/Llama: llama4:scout, llama3.3:70b
- Mistral: ministral-3:14b, mistral-small3.2:24b, mistral-large:123b
- Microsoft: phi4-reasoning:plus
- DeepSeek: deepseek-r1:70b
- Cohere: command-a:111b
Mac Studio jsme připravili jako čistý testovací stroj s nainstalovanou Ollamou a kompletně staženou sadou modelů. Samotné měření obsluhoval Python skript, takže jednotlivé modely postupně spouštěl, opakoval měření a výsledky automaticky ukládal.
Pro všechny modely jsme použili stejné zadání. Úkolem bylo vytvořit dlouhý odborný technický text o konstrukci moderního automobilu a pokračovat v generování až do dosažení nastaveného limitu. Maximální délka výstupu byla 2 000 tokenů, teplota generování byla nastavena na 0 a velikost kontextového okna na 8 192 tokenů.
Každý model jsme spustili jedenáctkrát. První běh se do výsledku nezapočítával a hodnota uvedená v tabulce je průměrem běhů 2 až 11. Na jeden model tak připadá deset započítaných měření. Mezi jednotlivými modely byla navíc 30sekundová pauza.
Celý benchmark zahrnoval 352 jednotlivých generování a Mac Studio během něj vytvořil 703 645 výstupních tokenů. První měření začalo v 8:56 a poslední skončilo ve 13:01. Kompletní test tedy zabral přibližně čtyři hodiny a pět minut.
Výkon zároveň nesmíme zaměňovat za kvalitu. Model s rychlostí 150 tok/s nemusí dávat lepší odpovědi než model, který zvládne 30 tok/s. V tomto testu vůbec neposuzujeme inteligenci modelů, správnost odpovědí nebo kvalitu vytvořeného textu. Měříme čistě rychlost inference na konkrétním hardwaru.
Velké modely už Mac Studio příliš netrápí
Právě u největších modelů začíná konfigurace s 256 GB jednotné paměti dávat největší smysl. Modely s desítkami miliard parametrů dnes sice není problém rozběhnout i na podstatně levnějším hardwaru, u variant s více než stovkou miliard parametrů se ale nároky na paměť i její propustnost rychle zvyšují.
Mac Studio přesto zvládl všech 32 modelů v jednom několikahodinovém testu. Dokonce i nejpomalejší Mistral Large 123B se udržel na 13,69 tok/s, zatímco velké modely optimalizované jako Mixture of Experts dokázaly běžet násobně rychleji. V praxi tak už nejde jen o ukázku toho, že se velký model do paměti vejde. Řada z nich je na tomto hardwaru dost rychlá i pro normální každodenní používání.
Další výhodou je samotný princip lokálního provozu. Data neopouštějí počítač a po stažení modelu už není každý další vygenerovaný token spojený s platbou provozovateli API. Limitem se tak místo ceny za výpočet stává především výkon hardwaru, dostupná paměť a samozřejmě pořizovací cena samotného Macu.
Zdroj: autorský text (měření), tomshardware
Obrázky: Ludvík Eckerman